
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:18600524535
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

在数字化转型的深水区,非结构化数据正成为企业最宝贵的资产之一。据估计,企业中超过80%的数据以文档形式存在——发票、合同、报表、病历等。然而,如何从这些格式各异、版面复杂的文档中高效、准确地提取关键信息,一直是行业痛点。
中科逸视(北京)科技有限公司推出的智能文档抽取系统,正是为了解决这一核心挑战而生。该系统并未简单沿用传统的OCR(光学字符识别)技术路线,而是整合了专业文档解析底座与大模型语义理解能力,构建了一套“视觉+认知”双引擎驱动的全新架构。
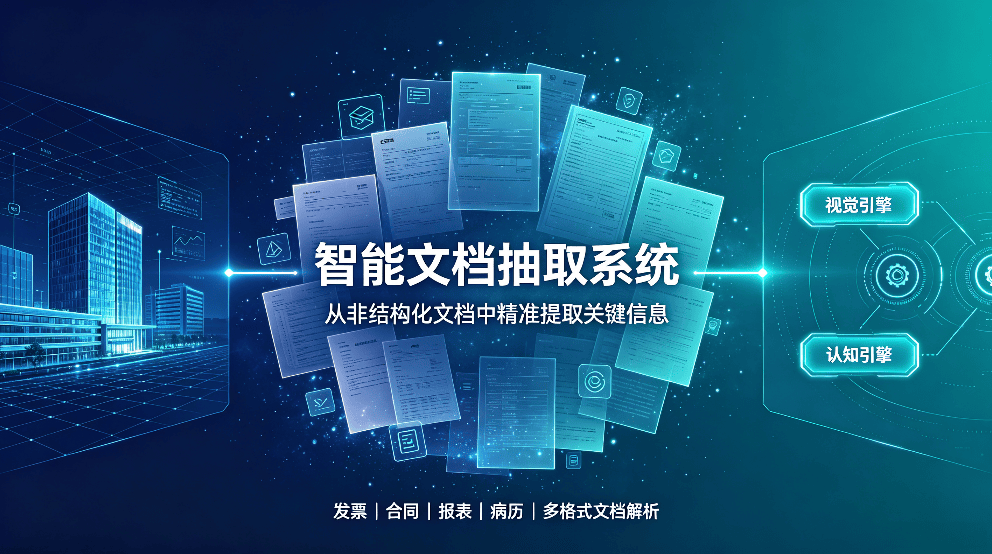
技术原理:“解析底座+大模型”的双轮驱动详解
中科逸视智能文档抽取系统的核心技术逻辑可以概括为:先“看清”结构,再“读懂”语义。它摒弃了以往“识别即结束”的单一路径,转而采用分层处理机制,将复杂任务拆解为高精度的视觉感知和深度的语义推理两个阶段。
1. 第一层:基于专业文档解析底座的精准视觉感知
这一层是系统的“眼睛”,其核心目标是解决“字在哪里”以及“它们属于哪个部分”的问题。中科逸视采用的专业文档解析底座,并非简单的图像二值化或文字识别工具,而是一个具备深度版面分析能力的多模态引擎。
版面分析:
高精度文本识别:
速度优化前提:
2. 第二层:基于大模型智能语义理解的深度认知
在获得高质量的文本和结构数据后,系统引入大语言模型(LLM)作为“大脑”。这一层解决的是“这些信息意味着什么”以及“用户想要什么”的问题。
指令跟随与自然语言交互:
上下文感知的语义抽取:
泛化性与灵活性:
3. 双层协同机制
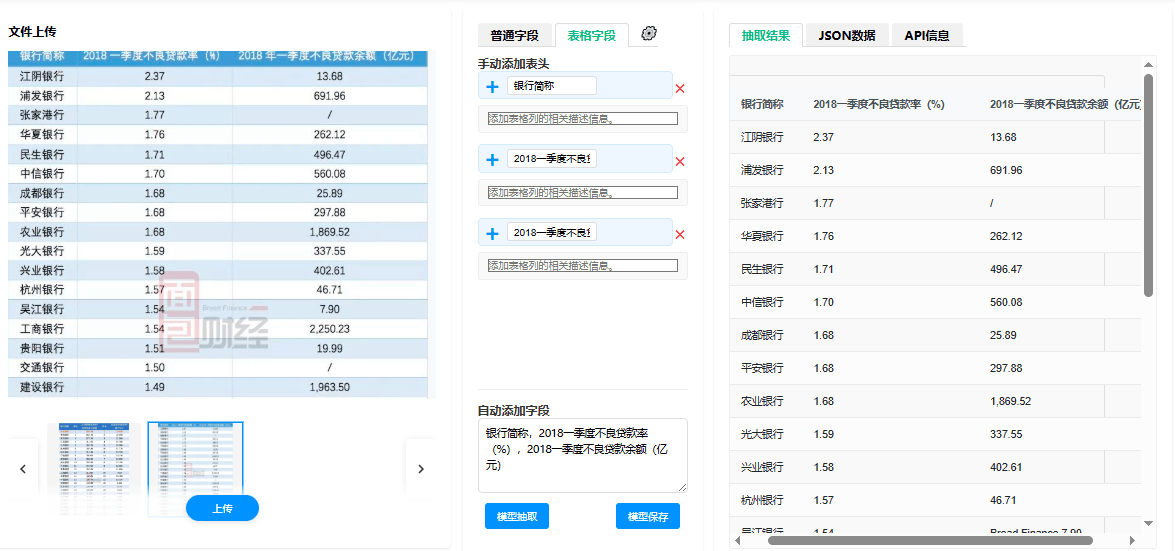
对比传统OCR 方案的核心优势
传统OCR 本质属于字符感知工具,仅能完成图像文字转译,缺少逻辑理解能力;中科逸视智能文档抽取系统实现感知与认知一体化,优势差距显著:
泛化能力更强,摆脱固定模板束缚
具备语义推理能力,解决信息分散难题
复杂场景综合准确率更高
部署与集成更加轻量化,交付效率更高
输出价值从“文字文本” 升级为 “业务可用数据”
中科逸视文档抽取系统并非简单地替代人工录入,而是通过“底座级的精准解析”消除噪声干扰,再通过“大模型级的弹性理解”跨越模板枷锁,真正实现了“一种能力适配千种文档”的通用性。在AI从“感知”迈向“认知”的当下,该技术为企业打通了非结构化数据转化为知识资产的最后一道关卡,正成为智能流程自动化、合规风控、数据中台建设中的关键基础设施。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2