
专注AI算法和大模型融合技术研发
-
商务合作
- 邮箱:easing@easingvision.com
- 手机:15600222447
- 电话:010-69992918
- Q Q:2175715190 点击交谈
- 地址:北京市龙发大街1号院3号楼4层
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2

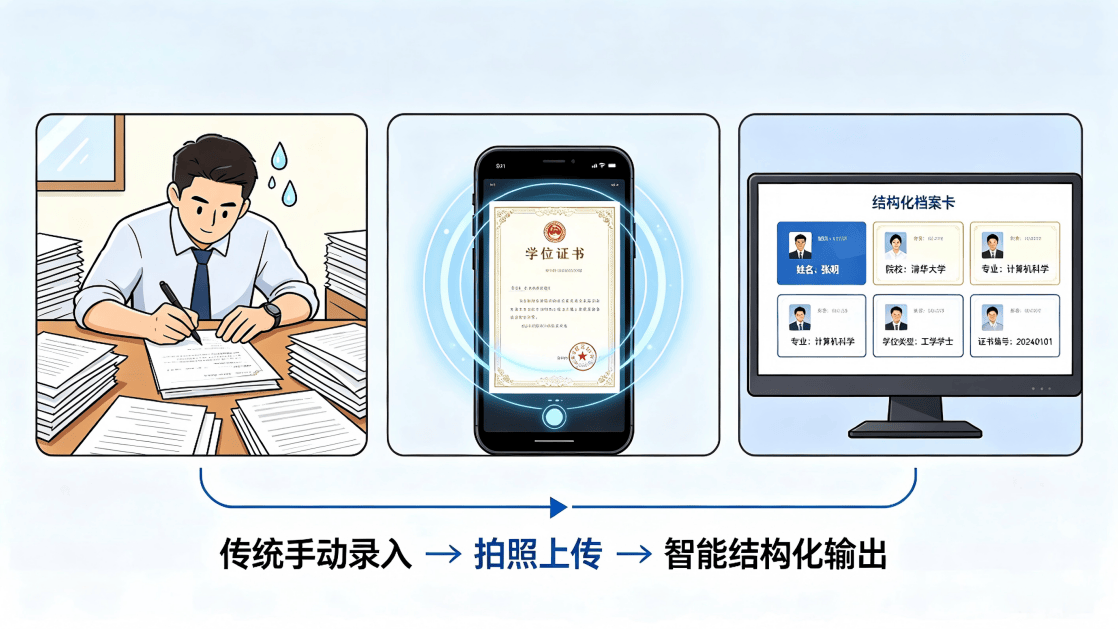
人才录入、学籍归档、资料审核、人才库搭建、资质备案……在人事、教育、政务日常工作中,学位证书信息录入是高频刚需环节。
放在以前,工作人员只能盯着纸质证书或扫描件,逐字手动抄写姓名、院校、专业、学位类型、证书编号等信息。一套完整信息录入下来,最少需要一两分钟,遇到大批量资料归档,耗时耗力还容易出现手打错字、漏填信息、格式混乱等问题。
而如今,学位证书智能识别技术彻底颠覆了传统人工录入模式:只需拍照或上传图片,3秒就能自动抓取、整理、结构化输出所有证书信息,无需手动打字、无需统一格式。很多人以为它只是简单的“拍照识字”,实则是一套精密的AI视觉黑科技系统。
今天,我们就来扒一扒这套“证照数字化神器”背后的门道,看看它是如何完成从“看见”到“理解”的智能跨越的。
技术原理:给AI装上“透视眼”与“逻辑脑”
如果把传统的OCR(光学字符识别)技术比作一个只会“描红字”的小朋友,那么中科逸视这项技术,就是一个拥有医学博士级严谨逻辑的“超级校对员”。它不是简单的图像拼接,而是一个复杂的系统工程,我们可以把它拆解为三个核心阶段来看:
1. 图像预处理:“扫清障碍”的魔法滤镜
现实世界中,很少有人能拍出完美的证件照。手机拍摄难免倾斜、光照不均,证书本身还可能因为折叠产生阴影和折痕,甚至红色的公章会挡住关键的年份和数字。
这时候,系统的多模态图像增强算法就派上用场了。它相当于给摄像头戴上了一副“智能眼镜”:
2. 智能定位与提取:比侦探还要精准的“寻物游戏”
画面干净了,接下来就是“认字”。中科逸视并没有使用传统死板的字符匹配,而是采用了端到端的深度学习架构。
3. 大模型赋能:赋予系统真正的“理解力”
这也是该技术目前最具“黑科技”感的一环。中科逸视将大语言模型(LLM)深度融入了识别链路中。 传统的OCR只是机械地输出图片里的像素点,而加入了大模型后,系统在最后一步具备了“常识推理”能力。如果识别结果中出现明显违背常理的组合(比如错误的学科代码),大模型会在后台默默进行二次校验和修正。这就像是请了一位资深专家站在旁边实时监工,确保最终吐出的数据结构既准确又合乎规范。
功能特点:不仅仅是“快”,更是“稳”与“准”
依托上述硬核技术,中科逸视学位证书识别系统在实际应用中展现出了几个非常直观的优势:
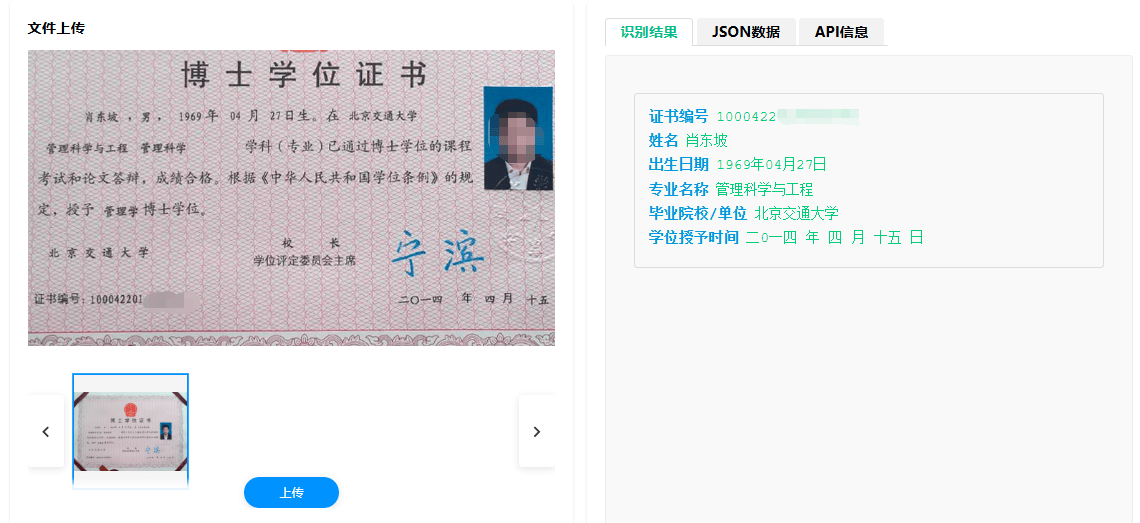
应用领域:无处不在的“守门人”
这项技术早已走出了实验室,成为了许多关键领域的基础设施:
从一堆杂乱的像素点到一条条精准的数据流,中科逸视用技术手段抹平了物理世界与数字世界之间的沟壑。它不声不响地运行在手机屏幕的背后,却实实在在地为我们节省下无数的宝贵时间。当“黑科技”学会了服务大众,我们日常面对的每一个繁琐环节,都会因此变得更加轻盈流畅。
专注AI算法和大模型融合技术研发
Copyright © 中科逸视(北京)科技有限公司 版权所有-备案号:京ICP备19041319号-2