一张纸的数字化突围:AI是怎么"读懂"汽车出生证明的
- 栏目:新闻动态 时间:2026-10-31 16:24 分享新闻到:
<返回列表
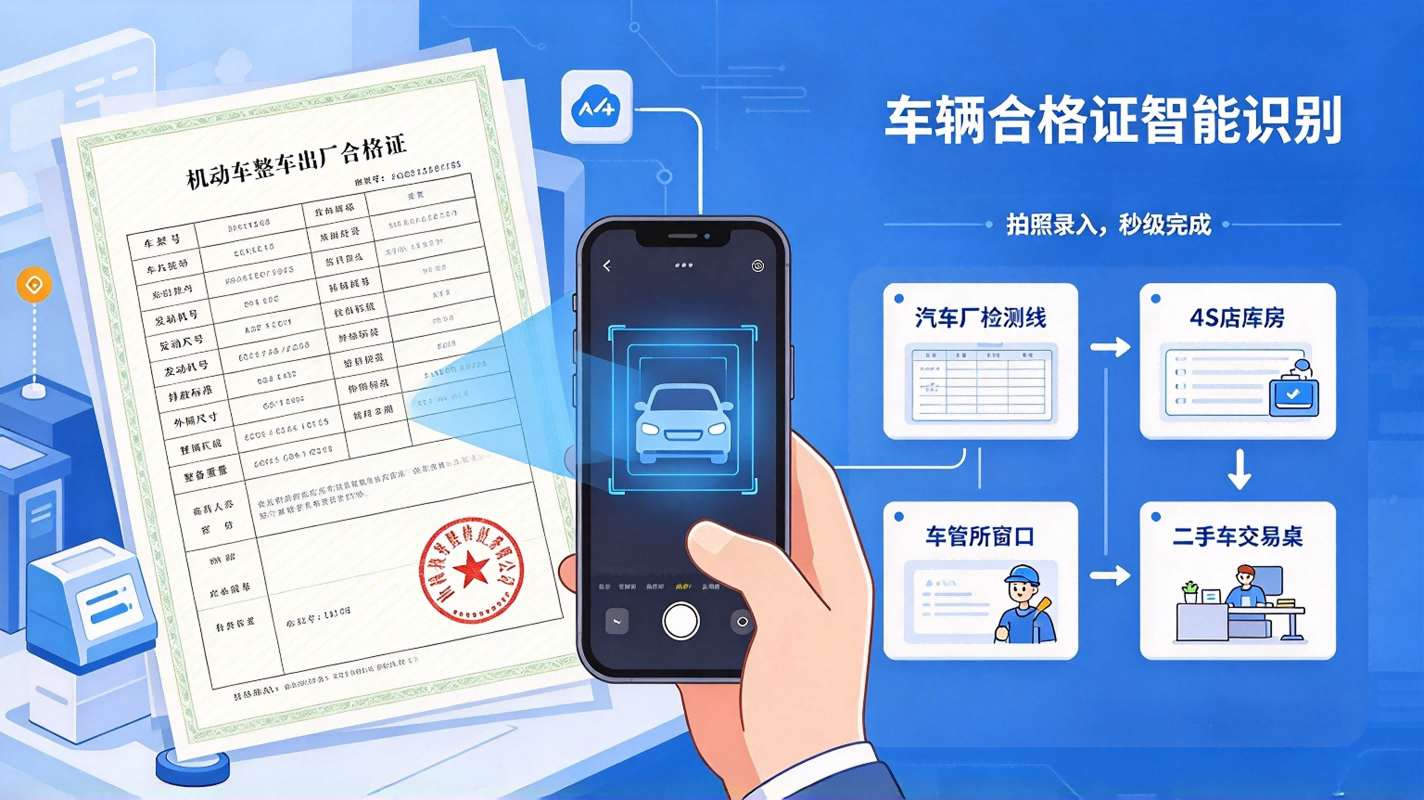
买过车的人大多见过那张纸——《机动车整车出厂合格证》。
A4大小,浅色底纹,红色印章,密密麻麻印着几十行字:车架号、发动机号、排放标准、外廓尺寸、轴距、整备质量……它是车辆的法定"出生证明",没有它,车没法上牌,也没法合法上路。
麻烦就出在这张纸上。它承载的信息极其关键,但载体是一张纸。从汽车厂的检测线、到4S店的库房、到车管所的窗口、到二手车的交易桌,每一个环节都要把它"搬"进电脑里——靠人一个字一个字地敲。
中科逸视(北京)科技有限公司的车辆合格证识别系统,说白了就是把这个"敲"的动作去掉:拍一张照,几秒钟,几十个字段自动填好。
听着像扫码一样轻松。但真要把这件事做稳,背后是一套相当细密的工程。这篇文章就把它的门道讲清楚。
很多人第一反应是:OCR(光学字符识别)不是早就有了吗?手机扫名片、扫发票、扫身份证,不是都挺好用?
-
第一,它不是"自由文本",是"高密度表格"。 一张合格证上,少的二三十个字段,多的四十几个,都是紧挨着排的。左边是字段名(比如"车辆识别代号/车架号"),右边是值。字号很小,行距很紧,机器稍微看偏一点,就可能把上一行的值填到下一行的字段里。
-
第二,干扰源特别多。合格证有底纹、有水印、有防伪图案,还经常盖着红章。章印盖在字上,字就被吃掉了;底纹的线条和笔画粗细接近,机器容易把底纹当成字。
-
第三,拍摄条件不可控。4S店的销售用手机在车边随手拍,纸张有折痕、有反光、有阴影、有倾斜角度,甚至只拍了局部。
所以普通的"整图OCR"在这张纸上会翻车:它能把字认出来,但认出来的是一堆没有归属的文本,还得人来对应。真正有用的,是把图像直接变成"字段名—字段值"的结构化数据。
这也是中科逸视车辆合格证识别系统和普通OCR最本质的区别:它不只"看见字",它还要"看懂这张表"。
整个流程可以拆成一条相对清晰的流水线。下面一步一步说。
摄像头拍下的那一帧,其实是很"脏"的。系统拿到图,不会急着认字,而是先做修复:
-
几何校正:检测纸张的四个角或边缘线,把倾斜的、被拍成梯形的图,拉回水平方正的状态。就像把一张斜着摆在桌上的纸,重新摆正。
-
去噪与去干扰:处理摩尔纹(用屏幕翻拍时出现的网格纹)、阴影、折痕。对合格证特有的浅色底纹和防伪网纹,算法会做专门的抑制,让笔画从背景里"浮"出来。
-
光照均衡:局部过曝或过暗的区域拉回正常亮度,避免一边字发白、一边字发黑。
-
印章分离:红章是这里的老大难。系统会把偏红色的像素通道单独拎出来处理,尽量把章的颜色"抽掉",保留下面的黑色笔画。
这一步不出结果,但它决定了后面所有环节的上限。业内常说"预处理做好了,识别就成功了一半",在这类证件上并不夸张。
这一步用的是基于深度学习的文本检测网络。它的工作方式,有点像拿一支荧光笔在图上把所有文字区域圈出来——不管字是横排、竖排,还是被章盖掉一半,都要圈到。
但光有"文字框"还不够。合格证是表格结构,所以系统还要再做一层版面分析:识别出这张表有几栏、哪一块是标题区、哪一块是参数区、哪一行的字段名对应右边哪一格的值。这一步产出的其实是"地图"——告诉后面的模块,某块文字大概属于什么位置、什么类别。
对表格类证件来说,版面分析的价值非常大。因为它把"从整张图里瞎找"变成了"在指定区域里精确找",既快又不容易出错。
框定区域后,进入真正的"认字"环节。这里的主力模型是 CRNN(卷积循环神经网络),它的结构可以拆成三层,从下往上依次是:
-
第一层,卷积层(CNN):负责从图像里提取笔画、边缘、结构这些视觉特征,干的是"看清这个字长什么样"的活。
-
第二层,循环层(RNN):负责对字符序列建模,利用前后文的关系做判断。
-
第三层,转录层(CTC):负责把序列特征对齐成最终文本,也就是"把认出来的字排成一句话"。
中间那层循环网络是关键。打个比方:你读一手潦草的字,几个字中间夹了个糊掉的字符,你不会孤立地去猜它,而是靠前后文的语感把它补出来。RNN 干的就是这件事——它知道"车辆识别代号"后面跟着的通常是一串大写字母和数字,不会突然冒出汉字。
-
字库适配:合格证上会出现一些不常见的字(地名、企业名里的生僻字)和专用符号,模型在训练时用大量真实样本覆盖了这些情况。
-
语义校正:识别结果会再过一层语言模型做二次判断。比如OCR 把"京"认成了形近的"亰",语言模型结合上下文就能把它纠回来。
字认出来了,还是一串串散落的文本。系统现在要做的是:这是"发动机号",那是"轴距"。
这一步用到的技术叫命名实体识别(NER)—从一段文本里判断出哪些是"实体"、属于哪一类。
合格证的处理有个讨巧的地方:它大多采用"字段名 + 字段值"的配对结构。所以系统可以同时用两套线索来判断:
-
空间线索:这个值在图上,是不是正好在"发动机号"这个标签的右侧同一行?
-
语义线索:这串字符的形态,符不符合发动机号的规律(长度、字母数字组合方式)?
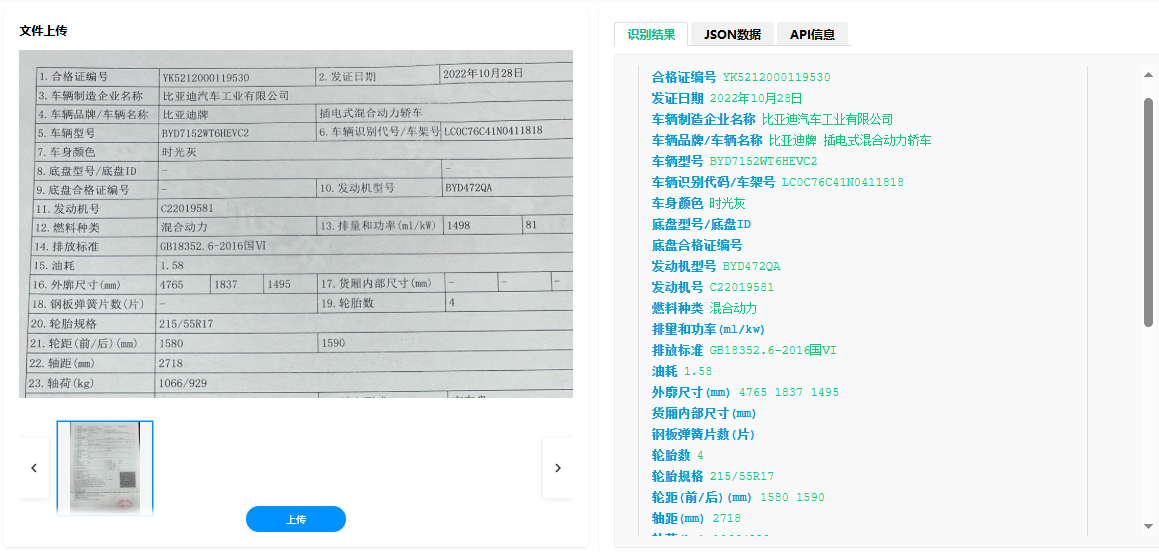
两条线索交叉验证,归属就基本不会错。像"排量和功率(ml/kW)"这种一格塞两个数的字段,系统还要再往下切一层,把 1498 和 81 分别归到排量和功率。
最终输出的是JSON 或 XML 格式的键值对,可以直接灌进业务系统,不需要人再加工一遍。
-
快:从上传图片到返回结构化结果,通常在几百毫秒到1 秒之间。人工录入一份合格证,熟手也要 5 到 10 分钟。这个差距不是"提升 30%",而是量级上的改变。
-
准:正常拍摄条件下,关键字段的准确率在99% 以上。更重要的是它不会闷头错——校验不过的字段会被明确标出来,让人知道该看哪儿。
-
能容错:倾斜、反光、折痕、印章遮挡、局部模糊,这些真实场景里的"不完美",都在训练和预处理环节被专门应对过。它不要求你拍得多专业。
-
版本兼容:国产机动车整车出厂合格证从2004 年至今经历过多轮版式调整,各厂家的排版细节也不完全一样。系统能自动适配不同版本,不需要为每一种版式单独写一套模板。
-
部署灵活:支持云端API 调用,也支持本地化部署。对数据不能出内网的机构(比如车管所、银行),后者是硬需求。
-
可迭代:遇到没见过的新版式,用少量样本做增量微调就能补上,不需要推倒重来。
车辆合格证识别技术服务的不是某一个行业,而是汽车从"出生"到"转手"的整条链路。
-
汽车生产与出厂:在总装线末端,合格证要和车辆VIN 做绑定核验,确保"车证一致"。过去靠人工比对,量大时容易漏;自动识别后可以逐台核,出厂核查和物流追踪都更顺。
-
经销商与4S 店:车辆到店入库、销售开单、办临牌、对接金融,每个环节都要用到合格证上的信息。扫一下自动进DMS 系统,单车入库从分钟级压到秒级,也避免了手工录入导致的"账实不符"。
-
车管所与车辆登记:新车上牌是合格证识别最典型的场景。窗口工作人员扫描证件,信息自动填入登记系统,减少排队时间,也减少因输错一位数导致退办、重打的麻烦。税务、环保核查也用得上同一份数据。
-
汽车金融与信贷:办贷款要核验车辆权属,合格证是核心凭证。系统能瞬间提取并校验关键信息,喂给风控模型做自动审批,缩短放款周期,同时也提高了伪造证件的成本。
-
保险投保与理赔。录入车辆信息、核实出厂参数、调取车辆档案,拍照即得,客户不用干等。
-
二手车交易:收车时快速核验合格证与车辆身份是否匹配,是防范套牌、拼装车的有效手段。对车商来说,这也是给自己上一道保险。
过去二十年,中国汽车产业的数字化主要发生在"系统"层面——ERP、DMS、CRM 一层层搭起来。可这些系统里跑的数据,很多还是人手工敲进去的。数据链条的第一个环节靠人工,后面所有的分析、风控、决策,可靠性都要打折扣。
车辆合格证识别技术的作用,是把这条链的入口自动化、标准化了。它让"纸"和"系统"之间不再需要一个人做翻译。
更多阅读
-
- 新闻动态 2026-10-31
- 买过车的人大多见过那张纸——《机动车整车出厂合格证》。
A4大小,浅色底纹,红色印章,...
查看全文
-
- 新闻动态 2026-10-30
- 开车、租车、注册网约车、买车险……生活里不少场景都要提交驾驶证。放在几年前,流程大...
查看全文
-
- 新闻动态 2026-10-29
- 想象一下:你坐在家里,掏出手机,对着屏幕眨眨眼、摇摇头,几秒钟后,一张新办的电话卡...
查看全文
返回全部新闻